
چطور PDF را برای ChatGPT و Claude آماده کنیم؟ تبدیل به Markdown و کاهش مصرف توکن
طبق راهنمای آپلود فایل OpenAI، در همه پلن های ChatGPT به جز Enterprise، مدل فقط متن دیجیتال داخل PDF را استخراج می کند و «تصاویر را کنار می گذارد». یعنی نمودار، اسکرین شات و هر جدولی که به شکل تصویر در فایل آمده باشد، اصلا به مدل نمی رسد. در API ماجرا برعکس است: هم OpenAI و هم Anthropic برای هر صفحه PDF، علاوه بر متن، یک تصویر کامل از صفحه را هم به مدل می دهند و بابت آن توکن حساب می کنند.
این دو رفتار متفاوت توضیح می دهد چرا تبدیل PDF به Markdown گاهی مصرف توکن را چند برابر کم می کند و گاهی تقریبا هیچ تفاوتی ایجاد نمی کند. برای نوشتن این راهنما دو فایل واقعی را با ابزار تبدیل PDF به Markdown کافه لایسنس تبدیل کردیم و توکن ها را شمردیم. یکی از این آزمون ها روی PDF فارسی بود و ایرادی را نشان داد که در ابزار خود ما هم وجود داشت.
ChatGPT، Claude و Gemini با فایل PDF چه می کنند
سه سرویس اصلی، PDF را به سه شکل متفاوت پردازش می کنند و همین تفاوت، هزینه و کیفیت پاسخ را تعیین می کند.
| سرویس | آنچه از PDF به مدل می رسد | هزینه و محدودیت مستند |
|---|---|---|
| اپلیکیشن ChatGPT (پلن های غیر Enterprise) | فقط متن دیجیتال، تصاویر حذف می شوند | سقف ۵۱۲ مگابایت و ۲ میلیون توکن برای هر فایل |
| API مدل های OpenAI | متن استخراج شده به همراه تصویر هر صفحه | حداکثر ۵۰ مگابایت، مصرف توکن به گفته OpenAI بیشتر می شود |
| API مدل های Claude | متن هر صفحه به همراه تصویر همان صفحه | ۱٬۵۰۰ تا ۳٬۰۰۰ توکن متن برای هر صفحه به اضافه هزینه تصویر، حداکثر ۶۰۰ صفحه |
| API مدل های Gemini | هر صفحه به صورت تصویر | ۲۵۸ توکن برای هر صفحه، حداکثر ۱٬۰۰۰ صفحه و ۵۰ مگابایت |
منبع هر ردیف: راهنمای آپلود فایل ChatGPT، مستندات ورودی فایل در API شرکت OpenAI، مستندات پشتیبانی PDF در Claude و مستندات Document understanding در Gemini که آخرین بار ۱ مهر ۱۴۰۵ (۲۳ سپتامبر ۲۰۲۶) به روز شده است.
مستندات Claude صریح است: «سیستم هر صفحه از سند را به تصویر تبدیل می کند. متن هر صفحه استخراج می شود و در کنار تصویر همان صفحه ارائه می شود.» OpenAI هم در مستندات API می نویسد پردازش PDF «هم متن استخراج شده و هم تصویر صفحات» را وارد کانتکست می کند و «ممکن است مصرف توکن را افزایش دهد».
Markdown چیست و چرا مدل های زبانی آن را خوب می فهمند
Markdown یک قالب متنی ساده است که جان گروبر آن را ساخت. صفحه رسمی Markdown هدف آن را نوشتن با «قالب متن ساده ای که خواندن و نوشتن آن آسان است» معرفی می کند. نسخه ۱٫۰٫۱ آن در ۲۶ آذر ۱۳۸۳ (۱۷ دسامبر ۲۰۰۴) منتشر شد و امروز استاندارد مشترک آن با نام CommonMark نگهداری می شود که آخرین نسخه آن ۰٫۳۱٫۲ است.
در Markdown ساختار سند با چند علامت مشخص می شود: # برای تیتر، - برای فهرست و خط های | برای جدول. مدل زبانی از روی همین علامت ها می فهمد کدام خط تیتر است و کدام سطر جدول. در متن خامی که از PDF استخراج می شود، این اطلاعات وجود ندارد. تیتر، پاورقی، شماره صفحه و ستون های کنار هم، همه پشت سر هم در یک رشته متن قرار می گیرند.
آزمون ما روی یک مقاله ۱۵ صفحه ای انگلیسی
برای آزمون اول، نسخه عمومی مقاله «Attention Is All You Need» را از arXiv دریافت کردیم. این فایل ۱۵ صفحه و حدود ۲٫۲ مگابایت حجم دارد و پر از جدول، فرمول و نمودار است. فایل را در ابزار تبدیل PDF به Markdown کافه لایسنس رها کردیم. تبدیل در مرورگر و در حدود ۵ ثانیه انجام شد.
برای شمارش توکن از کتابخانه tiktoken شرکت OpenAI و رمزگذار o200k_base استفاده کردیم. طبق جدول نگاشت مدل ها در کد tiktoken، مدل های GPT-4o، GPT-4.1 و GPT-5 از همین رمزگذار استفاده می کنند. نتیجه:
- خروجی Markdown ابزار: ۳۹٬۷۳۸ کاراکتر و ۹٬۵۵۰ توکن، یعنی به طور میانگین حدود ۶۳۷ توکن برای هر صفحه
- متن خام همان PDF که با کتابخانه PyMuPDF استخراج شد: ۱۰٬۱۳۳ توکن
- تیترهای اصلی مقاله در خروجی Markdown با علامت
#مشخص شده بودند
تفاوت Markdown و متن خام فقط حدود ۶ درصد بود. این عدد مهم است، چون ادعای رایج «Markdown چند برابر توکن کمتری مصرف می کند» را در همه موقعیت ها تایید نمی کند.
تبدیل به Markdown همیشه توکن کمتری مصرف نمی کند
نتیجه آزمون بالا را باید کنار جدول بخش اول گذاشت. سه وضعیت متفاوت وجود دارد:
اپلیکیشن ChatGPT: چون ChatGPT در پلن های غیر Enterprise فقط متن PDF را استخراج می کند، Markdown از نظر تعداد توکن تفاوت زیادی ایجاد نمی کند. در آزمون ما این تفاوت حدود ۶ درصد بود. مزیت اصلی در این حالت ساختار است، نه صرفه جویی: مدل تیترها و فهرست ها را تشخیص می دهد و خودتان هم پیش از ارسال می بینید دقیقا چه متنی به مدل می رسد.
API مدل های Claude و OpenAI: این جا تفاوت واقعی است. Anthropic برای هر صفحه ۱٬۵۰۰ تا ۳٬۰۰۰ توکن متن اعلام کرده و هزینه تصویر صفحه را هم جداگانه حساب می کند. طبق مستندات Vision در Claude، هزینه هر تصویر برابر است با تعداد بلوک های ۲۸ در ۲۸ پیکسلی آن، و یک تصویر ۱۰۰۰ در ۱۰۰۰ پیکسلی ۱٬۲۹۶ توکن مصرف می کند. Anthropic منتشر نکرده صفحات PDF با چه وضوحی به تصویر تبدیل می شوند، پس عدد دقیق هزینه تصویر هر صفحه را نمی توان از بیرون محاسبه کرد. با این حال وقتی فقط متن Markdown ارسال شود، کل هزینه تصویر حذف می شود. یک نکته برای مقایسه منصفانه: رمزگذار Claude با o200k_base یکی نیست، پس عدد ۶۳۷ توکن در صفحه که ما اندازه گرفتیم را نمی توان مستقیما با عدد ۱٬۵۰۰ تا ۳٬۰۰۰ Anthropic مقایسه کرد.
API مدل های Gemini: Google هر صفحه PDF را ۲۵۸ توکن حساب می کند. برای مقاله ۱۵ صفحه ای ما این یعنی ۳٬۸۷۰ توکن، در حالی که Markdown همان مقاله ۹٬۵۵۰ توکن بود (با رمزگذار OpenAI). مستندات Gemini همچنین می گوید در Gemini 3 برای توکن های متن بومی استخراج شده از PDF هزینه ای دریافت نمی شود. پس در Gemini ارسال مستقیم PDF ممکن است ارزان تر از Markdown باشد.
بنابراین قاعده عملی این است: اگر با API مدل های Claude یا OpenAI کار می کنید و تصویر صفحه ها برای پاسخ لازم نیست، Markdown هزینه را به طور محسوس کم می کند. اگر از اپلیکیشن ChatGPT استفاده می کنید، دلیل تبدیل کیفیت و کنترل است. برای روش های دیگر کاهش مصرف، مقاله روش های کاربردی کاهش مصرف توکن در ChatGPT و Claude را ببینید.
PDF فارسی: چرا متن برعکس و به هم ریخته استخراج می شود
متن فارسی در حافظه کامپیوتر به ترتیب «منطقی» ذخیره می شود، یعنی به همان ترتیبی که خوانده می شود. الگوریتم دوطرفه یونیکد (UAX #9) صریحا می گوید استاندارد یونیکد «ترتیب منطقی» را برای ذخیره متن تعیین کرده و راست به چپ بودن فقط به نمایش مربوط است.
بسیاری از فایل های PDF این قاعده را رعایت نمی کنند. PDF در اصل برای چاپ ساخته شده و فقط جای هر حرف روی صفحه را نگه می دارد. در فایل های فارسی و عربی دو مشکل رایج پیش می آید:
- ترتیب دیداری: حروف به ترتیبی که روی صفحه از چپ به راست دیده می شوند ذخیره شده اند. نتیجه استخراج، کلمات وارونه است. در گزارش خطای شماره ۲۳۳۶ پروژه MarkItDown مایکروسافت که ۲ شهریور ۱۴۰۵ (۲۴ اوت ۲۰۲۶) ثبت شده، همین مشکل برای متن عربی شرح داده شده است: کاراکترها و کلمات «بر اساس جای دیداری در PDF استخراج می شوند و نه ترتیب منطقی یونیکد».
- شکل های نمایشی حروف: به جای حرف استاندارد «ن»، شکل چسبیده آن در ابتدا، وسط یا انتهای کلمه ذخیره شده است. این شکل ها در بازه های U+FB50 تا U+FDFF و U+FE70 تا U+FEFE یونیکد قرار دارند و فصل ۹ استاندارد یونیکد می گوید این شکل ها «نباید در تبادل عمومی متن استفاده شوند». مدل زبانی و موتور جستجو، این حروف را با حروف معمولی فارسی یکسان نمی بینند.
این مشکل تازه نیست. در گزارش شماره ۲۱۴۱ پروژه pdf.js که سال ۱۳۹۱ (۲۰۱۲) ثبت شده، کاربری نشان داده کلمه «انواع» هنگام کپی به شکل وارونه و با حروف نمایشی بیرون می آید.
آزمون ما روی PDF فارسی و ایرادی که در ابزار خودمان پیدا شد
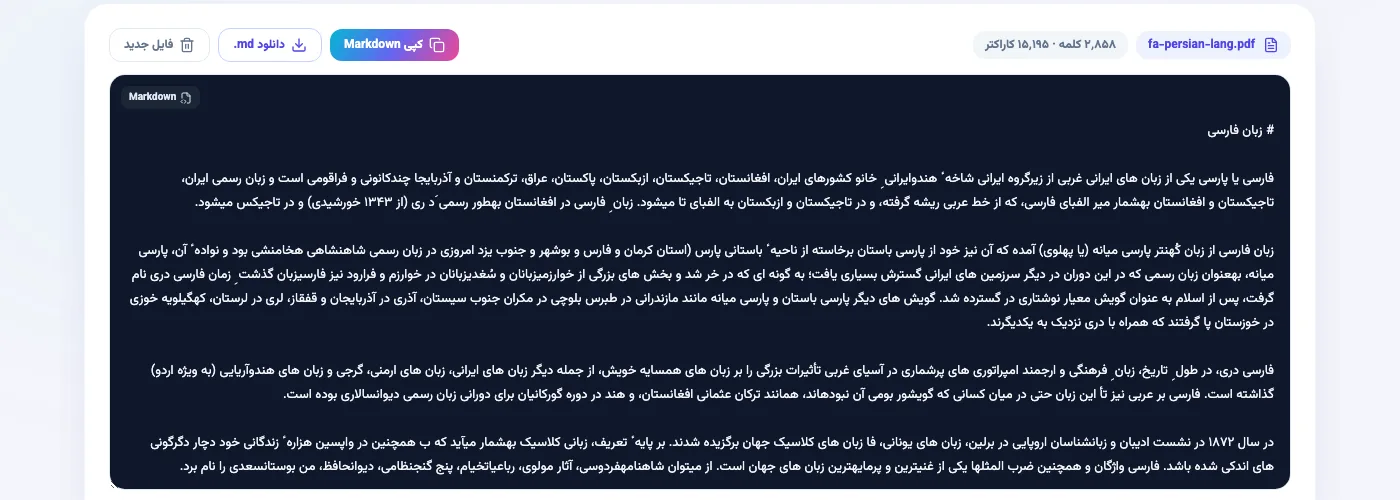
برای آزمون دوم، مقاله «مارک داون» ویکی پدیای فارسی را در مرورگر Chromium با گزینه ذخیره به عنوان PDF ذخیره کردیم. این رایج ترین راهی است که کاربران از یک صفحه وب فایل PDF می سازند. نتیجه یک فایل سه صفحه ای بود.
در اولین اجرا، خروجی ابزار کافه لایسنس دقیقا دچار هر دو مشکل بالا بود. عبارت «مارک داون» به صورت وارونه و با حروف نمایشی استخراج شد و بسیاری از خطوط معمولی، به اشتباه به عنوان تیتر علامت گذاری شدند. کتابخانه PyMuPDF روی همان فایل ترتیب کلمات را درست تر برگرداند، اما عدد ۲۰۰۴ را به صورت «۰۰۲۴» و ۱۷ را به صورت «۷۱» استخراج کرد و جای پرانتزها را برعکس گذاشت.
ما روش استخراج PDF را در ابزار اصلاح کردیم و نسخه جدید در ۳ مهر ۱۴۰۵ (۲۵ سپتامبر ۲۰۲۶) منتشر شد. اکنون در خطوطی که حروف فارسی دارند، قطعه های متن بر اساس جای آن ها روی صفحه از راست به چپ مرتب می شوند، عبارت های لاتین و اعداد ترتیب خود را حفظ می کنند، پرانتزها قرینه می شوند و شکل های نمایشی به حروف استاندارد فارسی تبدیل می شوند. در آزمون مجدد همان فایل این نتیجه به دست آمد:
| معیار | پیش از اصلاح | پس از اصلاح |
|---|---|---|
| کاراکترهای شکل نمایشی در خروجی | ۳۲۰ | ۰ |
| خطوطی که تیتر علامت گذاری شدند | ۳۸ | ۷ |
| عنوان مقاله | وارونه و با حروف جدا | درست |
| تاریخ ۲۵ مارس ۲۰۰۴ | وارونه | درست |
دو ایراد باقی ماند. نیم فاصله ها در خود PDF ذخیره نشده بودند، پس کلماتی مثل «توسعه دهنده» به صورت چسبیده استخراج شدند و هیچ مبدلی نمی تواند فاصله ای را که در فایل وجود ندارد بازسازی کند. در یک سطر هم که پرانتز و شماره ارجاع کنار هم قرار داشتند، ترتیب پرانتزها کاملا درست نشد.
درس عملی این آزمون برای هر ابزاری، از جمله ابزار خود ما: پیش از ارسال یک PDF فارسی به ChatGPT یا Claude، دو سه خط از خروجی متنی را بخوانید. اگر کلمات وارونه یا حروف جدا از هم دیدید، مدل هم همان متن خراب را دریافت می کند و پاسخ آن به همان اندازه غیرقابل اعتماد است.
اگر فایل Word را دارید، به جای PDF آن را تبدیل کنید
فایل DOCX متن را به ترتیب منطقی و همراه با اطلاعات ساختاری مثل سبک تیتر، فهرست و جدول نگه می دارد. به همین دلیل تبدیل DOCX به Markdown مشکل ترتیب دیداری و حروف نمایشی را ندارد. اگر PDF از روی یک فایل Word ساخته شده و فایل اصلی در دسترس است، همان فایل Word را در ابزار رها کنید. تیترهای Word در خروجی به تیترهای Markdown تبدیل می شوند و جدول ها ساختار سطر و ستون را حفظ می کنند.
مراحل آماده کردن PDF با ابزار تبدیل PDF به Markdown
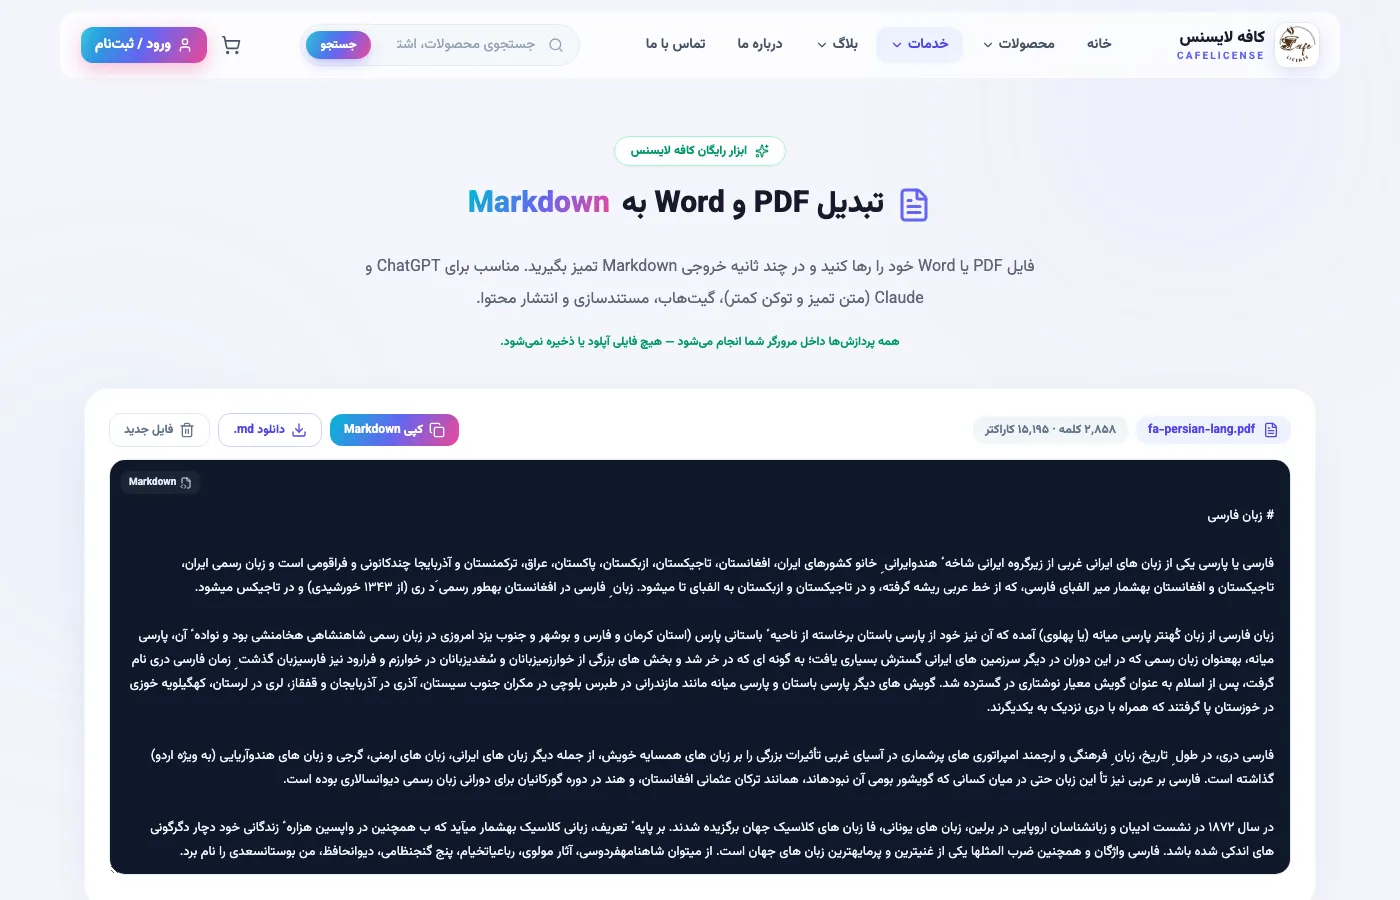
- صفحه ابزار رایگان تبدیل PDF و Word به Markdown را باز کنید.
- فایل PDF، DOCX، HTML، CSV یا TXT را روی کادر ابزار رها کنید. پردازش داخل مرورگر شما انجام می شود و فایل به هیچ سروری ارسال نمی شود.
- چند ثانیه صبر کنید تا خروجی نمایش داده شود. ابزار تعداد کلمات و کاراکترها را بالای خروجی نشان می دهد.
- خروجی را مرور کنید. برای فایل فارسی، بخش بعدی را حتما بخوانید.
- با دکمه کپی، متن را مستقیم در گفتگوی ChatGPT یا Claude قرار دهید یا با دکمه دانلود، فایل md بگیرید و آن را آپلود کنید.
بعد از تبدیل: اصلاح هایی که ارزش چند دقیقه وقت را دارند
خروجی هر مبدل خودکاری نیاز به یک بازبینی کوتاه دارد. این اصلاح ها بیشترین اثر را روی کیفیت پاسخ مدل دارند:
- حذف بخش های بی فایده: فهرست منابع، سرصفحه و پاصفحه تکراری، شماره صفحه ها و متن حق نشر را حذف کنید، مگر این که سوال شما درباره همین بخش ها باشد. در مقاله آزمون ما، فهرست منابع بخش قابل توجهی از متن بود.
- بررسی تیترها: اگر یک خط معمولی به اشتباه با
#شروع شده، علامت را حذف کنید. مدل از روی تیترها ساختار سند را می فهمد. - بررسی جدول ها: جدول هایی که در PDF با خط کشی ساخته شده اند، گاهی به صورت متن پشت سر هم استخراج می شوند. اگر سوال شما به یک جدول وابسته است، آن جدول را دستی مرتب کنید.
- تقسیم فایل های بلند: اگر فقط درباره یک فصل سوال دارید، فقط همان فصل را ارسال کنید. این ساده ترین راه کاهش توکن است و هیچ ابزاری جای آن را نمی گیرد.
PDF اسکن شده: وقتی اصلا متنی برای استخراج وجود ندارد
PDF اسکن شده در واقع مجموعه ای از عکس ها است و لایه متنی ندارد. ابزار تبدیل به Markdown و همچنین اپلیکیشن ChatGPT در پلن های غیر Enterprise که فقط متن دیجیتال را می خوانند، از چنین فایلی چیزی به دست نمی آورند. راه ساده تشخیص این است که در نمایشگر PDF سعی کنید یک کلمه را انتخاب کنید. اگر کلمه انتخاب نمی شود، فایل لایه متنی ندارد.
برای این فایل ها ابتدا باید OCR انجام شود. در این حالت خاص، ارسال مستقیم PDF به API مدل Claude یا Gemini منطقی تر است، چون این سرویس ها تصویر صفحه را هم به مدل می دهند و مدل می تواند متن را از روی تصویر بخواند.
شکل ها و نمودارها در تبدیل از بین می روند
Markdown متنی است. هر نمودار، عکس یا دیاگرامی که در PDF وجود دارد، در خروجی حذف می شود. اگر سوال شما به یک نمودار وابسته است، مثلا «روند فروش در نمودار صفحه ۴ چیست»، تبدیل به Markdown پاسخ را غیرممکن می کند. در این حالت یا از همان صفحه اسکرین شات بگیرید و جداگانه ارسال کنید، یا کل PDF را به سرویسی بدهید که تصویر صفحات را پردازش می کند. طبق راهنمای OpenAI، در اپلیکیشن ChatGPT فقط پلن Enterprise قابلیت Visual Retrieval را برای فایل های PDF دارد.
محدودیت های آپلود فایل در ChatGPT که با Markdown دور زده نمی شوند
راهنمای OpenAI محدودیت های زیر را برای آپلود فایل اعلام کرده است:
- حداکثر ۵۱۲ مگابایت برای هر فایل
- حداکثر ۲ میلیون توکن برای هر فایل متنی یا سند
- حداکثر ۸۰ فایل در هر ۳ ساعت، و برای کاربران رایگان فقط ۳ آپلود در روز
- در پروژه ها، ۵ فایل برای پلن رایگان، ۲۵ فایل برای Go و Plus، و ۴۰ فایل برای Pro و پلن های سازمانی
چسباندن متن Markdown در پیام، آپلود فایل محسوب نمی شود. پس کاربری که در پلن رایگان سهمیه ۳ آپلود روزانه را تمام کرده، هنوز می تواند متن یک سند کوتاه را مستقیم در گفتگو قرار دهد. این روش برای سندهای طولانی مناسب نیست، چون پیام های بسیار بلند در همان گفتگو فضای کانتکست را پر می کنند.
کاربران ایرانی: دسترسی، حساب کاربری و فایل های فارسی
ایران در فهرست کشورهای پشتیبانی شده OpenAI قرار ندارد. OpenAI در همان صفحه می نویسد دسترسی به خدماتش از خارج این فهرست «ممکن است به مسدود یا معلق شدن حساب منجر شود». فهرست کشورهای پشتیبانی شده Anthropic هم ایران را شامل نمی شود. دلایل رایج مسدود شدن حساب ها و راه های کاهش این ریسک در مقاله چرا اکانت ها بن می شوند بررسی شده است.
این وضعیت دو پیامد عملی برای کار با فایل دارد. اول این که بسیاری از کاربران ایرانی با پلن رایگان کار می کنند و سقف ۳ آپلود روزانه زود پر می شود. تبدیل فایل به Markdown و چسباندن متن، این سقف را برای سندهای کوتاه بی اثر می کند. دوم این که بخش زیادی از PDF های فارسی، از جمله قراردادها، جزوه ها و گزارش های اداری، از ابزارهایی خروجی گرفته شده اند که حروف را به ترتیب دیداری یا با شکل های نمایشی ذخیره می کنند. اگر چنین فایلی مستقیم به ChatGPT داده شود، کاربر نمی بیند مدل چه متنی دریافت کرده است. با تبدیل به Markdown، متن پیش از ارسال قابل دیدن و قابل اصلاح است.
تبدیل فایل مشکل دسترسی یا محدودیت پلن رایگان را حل نمی کند. اگر برای کار روزانه به سقف آپلود بیشتر یا پروژه های با فایل بیشتر نیاز دارید، اشتراک ChatGPT Plus و اشتراک Claude در کافه لایسنس روی حساب شخصی فعال می شوند. خرید اشتراک، ریسک های مربوط به محدودیت کشوری که در بالا آمد را از بین نمی برد.
سوالات متداول
آیا ChatGPT می تواند PDF فارسی را مستقیم بخواند؟
ChatGPT متن دیجیتال داخل PDF را استخراج می کند. اگر متن فارسی فایل به ترتیب منطقی و با حروف استاندارد ذخیره شده باشد، خواندن آن مشکلی ندارد. اگر فایل از نوع ترتیب دیداری باشد، کیفیت استخراج قابل پیش بینی نیست و OpenAI جزئیات روش استخراج خود را منتشر نکرده است. تبدیل به Markdown به شما امکان می دهد پیش از ارسال، متن را ببینید.
کدام برای Claude بهتر است، PDF یا Markdown؟
اگر سوال شما به متن مربوط است، Markdown هزینه تصویر صفحات را حذف می کند. اگر سوال به نمودار، امضا، مهر یا چیدمان صفحه مربوط است، PDF بهتر است، چون Claude تصویر هر صفحه را هم می بیند.
ابزار کافه لایسنس فایل را کجا ذخیره می کند؟
هیچ جا. تبدیل کاملا داخل مرورگر انجام می شود و فایل به سرور کافه لایسنس یا سرور دیگری ارسال نمی شود. به همین دلیل برای قراردادها و اسناد محرمانه هم قابل استفاده است. البته متنی که بعد از تبدیل در ChatGPT یا Claude قرار می دهید، طبق سیاست های همان سرویس پردازش می شود.
چرا خروجی بعضی PDF ها کاملا خالی است؟
فایل احتمالا اسکن شده است و لایه متنی ندارد. برای این فایل ها باید ابتدا OCR انجام شود یا PDF مستقیما به سرویسی داده شود که تصویر صفحه را پردازش می کند.
آیا تبدیل به Markdown برای Gemini هم مفید است؟
از نظر هزینه لزوما نه. Gemini هر صفحه را ۲۵۸ توکن حساب می کند که برای مقاله آزمون ما از Markdown همان مقاله کمتر بود. Markdown در Gemini بیشتر برای حذف بخش های اضافه و کنترل متن ارسالی مفید است.
برای تبدیل متن به کد HTML هم ابزاری وجود دارد؟
بله. اگر هدف شما انتشار متن در سایت یا ایمیل است و نه ارسال به مدل زبانی، از ابزار تبدیل متن به HTML استفاده کنید. این ابزار هم رایگان است و داخل مرورگر کار می کند.